이 블로그의 게시글 파일은 components/board/에 01-koin-di-kmp.md처럼 두 자리 순번을 붙여 쌓입니다. 새 글을 쓸 때마다 기존 파일 중 가장 큰 번호 다음 번호를 쓰기로 되어 있는데, 디렉터리를 쭉 훑어보다가 이상한 걸 발견했습니다. 66번 파일이 두 개, 71번도 두 개, 72번도 두 개였습니다.
66-nextjs-meta-description-html-leak-bug.md
66-hock-tan-ai-casino-remark.md

71-claude-code-send-user-file.md
71-task-management-app-mcp-comparison.md

72-claude-code-agent-isolation-worktree.md
72-butterfly-mcp-claude-integration.md
같은 번호를 쓴 파일이 세 쌍이나 있다는 건, "다음 번호를 고른다"는 아주 단순한 규칙이 세 번이나 지켜지지 않았다는 뜻입니다. 원인을 추적해봤습니다.
실제로 문제가 되는지부터 확인
번호가 겹쳐도 화면에 영향이 없다면 그냥 넘어갈 수 있는 일입니다. 먼저 게시글 목록을 읽어오는 코드를 봤습니다.
// components/board/posts.ts — 파일 하나를 Post 객체로 변환하는 부분
const id = file.replace(/\.(md|markdown|html|htm)$/i, '')
return {
  id,
  title: data.title ?? id,
  format: ext.startsWith('htm') ? 'html' : 'md',
  source: content.trim(),
  createdAt: data.createdAt ? new Date(data.createdAt).getTime() : 0,
  tags: parseTags(data.tags),
} satisfies Post
그리고 목록을 정렬하는 부분은 이렇습니다.
// components/board/posts.ts — 변환된 Post 배열을 정렬하는 부분
return posts.sort((a, b) => b.createdAt - a.createdAt || a.id.localeCompare(b.id))
정렬은 앞자리 번호가 아니라 frontmatter의 createdAt으로 하고, id도 파일명 전체 문자열이라 번호만 겹친다고 두 글이 같은 id가 되는 것도 아닙니다. 즉 화면에 보이는 순서나 링크에는 아무 문제가 없었습니다. 번호는 그냥 사람이 다음 파일을 만들 때 참고하는 메모 수준의 값이었던 겁니다.
그래도 찜찜했습니다. 번호가 순번이라는 전제를 믿고 "71번이 최근 글이구나" 하고 넘겨짚을 사람이 있을 수 있고, 무엇보다 "다음 번호를 정확히 계산한다"는 과정 자체가 매번 실패하고 있다는 신호였기 때문입니다.
겹친 시점을 git log로 확인
가장 먼저 의심한 건 동시성 문제였습니다. 이 블로그는 스케줄 작업이 주기적으로 새 글을 커밋하는 구조라, 두 작업이 거의 같은 시각에 "현재 최대 번호"를 읽어서 똑같이 +1 한 뒤 각자 커밋했다면 번호가 겹칠 수 있습니다.
$ git log --format="%h %ad %s" --date=short -- "66-*.md" "71-*.md" "72-*.md"
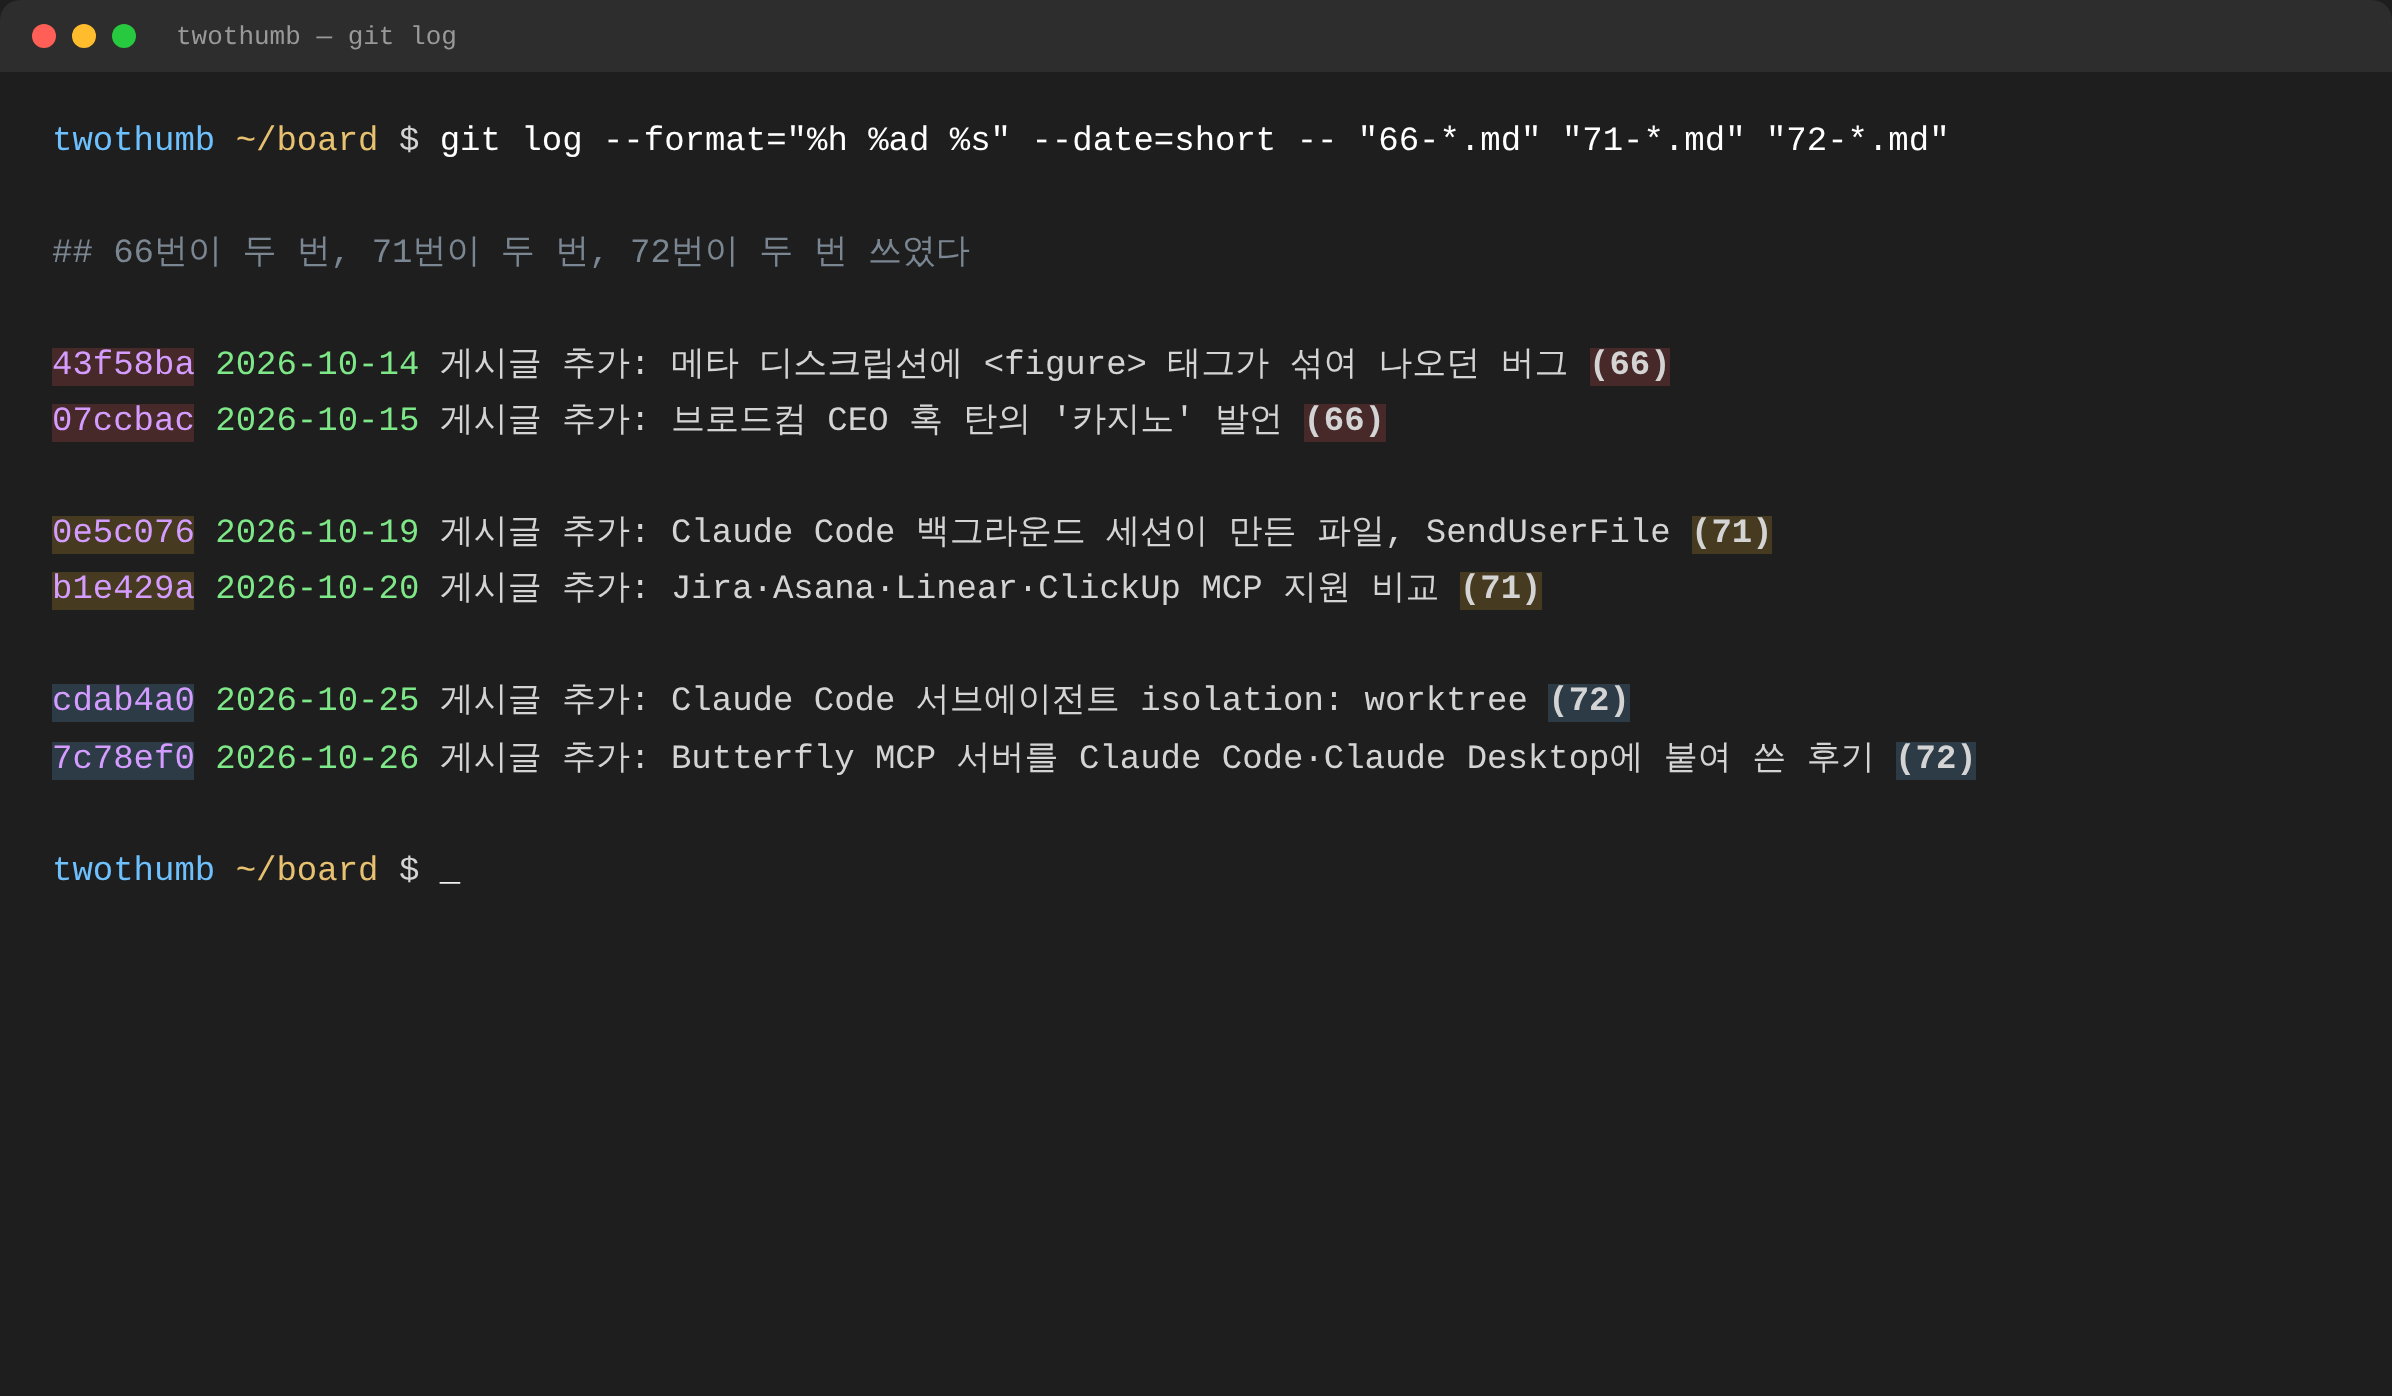
결과를 보면 동시성 문제가 아니었습니다. 66번 두 커밋은 하루 차이(10/14 → 10/15), 71번은 하루 차이(10/19 → 10/20), 72번도 하루 차이(10/25 → 10/26)로 모두 순차적으로 일어났습니다. 심지어 뒤쪽 커밋의 부모가 앞쪽 커밋이라 브랜치가 갈라졌다가 합쳐진 흔적도 없었습니다. git log --graph로 봐도 일직선입니다.
즉 "번호 71짜리 파일을 새로 만들 때, 디렉터리 안에 이미 71번 파일이 있다는 걸" 매번 놓친 겁니다. 스테일 체크아웃도, 레이스 컨디션도 아니고 단순히 셈을 잘못한 것에 가까웠습니다. 파일이 70개 넘게 쌓인 디렉터리를 ls로 눈으로 훑어서 "가장 큰 번호"를 판단하다 보면, 시황 리포트 파일(market-2026-10-14.md 같은 날짜형 파일명)이 섞여 있는 목록 중간에서 한 줄 정도는 놓치기 쉽습니다.
눈으로 세지 않도록 커맨드로 고정
재발을 막는 방법은 거창할 게 없었습니다. "가장 큰 번호를 찾아라"는 말을 명령 하나로 바꾸면 됩니다.
$ ls components/board | grep -v '^market-' | grep -oP '^[0-9]+' | sort -n | tail -1
77
grep -v '^market-'로 시황 리포트를 먼저 걸러내고, grep -oP '^[0-9]+'로 파일명 맨 앞 숫자만 뽑은 다음, sort -n으로 반드시 숫자 정렬을 합니다. 지금은 번호가 전부 두 자리라 -n 없이 문자열로 정렬해도 결과가 같지만, 100번을 넘어가 세 자리 번호가 섞이는 순간 문자열 정렬은 "99"를 "100"보다 뒤로 보냅니다. 두 자리일 때 굳이 숫자 정렬을 습관 들여두면 자리수가 바뀌는 시점에 또 같은 실수를 반복하지 않습니다.
결과가 77이면 다음 파일은 78번. 이 한 줄을 실행하고 그 출력을 그대로 보고 번호를 정하면, 적어도 "눈으로 셌다가 한 줄 놓치는" 실수는 구조적으로 없어집니다.
느낀 점
이번 글 자체도 이 커맨드로 번호를 확인하고 78번을 받았습니다. 겹친 세 쌍은 어차피 화면 동작에는 영향이 없으니 지금 와서 파일명을 다시 붙이진 않기로 했습니다 — 과거 커밋 히스토리를 건드리는 비용이 더 크기 때문입니다.
돌아보면 "가장 큰 번호 다음 번호를 쓰세요" 같은 지시는 말로는 간단해 보여도, 실행하는 쪽이 매번 직접 세어야 한다면 목록이 길어질수록 틀릴 확률이 올라갑니다. 반복되는 판단을 말로만 지시하지 않고 명령 한 줄로 고정해두면, 적어도 그 지점에서는 같은 실수가 반복되지 않습니다.